 Athena Engine 1.0
Modelli di prima fascia su un computer da scrivania
Athena Engine fa girare modelli che di solito vivono nei data center su un solo NVIDIA GB10: DGX Spark o ASUS Ascent GX10. Abbastanza veloce per il lavoro vero: documenti lunghi, conversazioni lunghe, agenti.
Misurato su un GB10
Modelli
Quattro modelli, un solo nome
L'API serve sempre il modello come «Athena»: configuri i client una volta, e continuano a funzionare quando passi da DeepSeek a Qwen.
Il modello principale per conversazioni lunghe e agenti.
Lo stesso modello, che legge anche le immagini.
Legge immagini e documenti (PDF, DOCX, Markdown, HTML) insieme al testo.
340 GiB su una macchina da 128 GB: il motore tiene in memoria ciò che serve a ogni token e legge il resto dall'SSD. 14,8 token al secondo.
Novità della 1.0
Non solo chat: un'intera macchina di servizi
Parla e ascolta
Le rotte audio di OpenAI con Qwen3-TTS e Qwen3-ASR: il primo audio parte in 0,06 s, 12 secondi di parlato trascritti in 0,6 s.
Ricerca multimodale
EmbeddingGemma 2 mette testo, immagini, video e suoni nello stesso spazio: una ricerca a parole trova una foto, una clip o una registrazione. Più il rerank.
Video con audio
LTX 2.5 di Lightricks crea clip con il loro audio da una descrizione o da un'immagine, fino al Full HD. Quattro secondi in circa 100 s, con la chat accesa.
Il guardiano della memoria
Voce, conversazioni, ricerca e video chiedono memoria a un solo guardiano, per priorità. Una conversazione che lavora non resta mai senza.
Nessuna conversazione letta due volte
Il contesto resta su disco e si riprende in un attimo, anche dopo un riavvio. Gli agenti ripartono dal prefisso già letto, giro dopo giro.
Compatibile con quello che usi
Endpoint compatibili con OpenAI e Anthropic, con streaming e tool call: i client e gli agenti che usi già funzionano senza modifiche.
Installa
Pronto in pochi minuti
Con Docker, dall'immagine pubblica, oppure con lo script di installazione. Le istruzioni complete, i modelli e le API sono nel README.
La chiave API è facoltativa, e c'è una guida per mettere HTTPS davanti al motore. Gratuito per uso personale, ricerca, didattica, e per sviluppatori e piccole aziende al lavoro.
Athena Engine su GitHub →docker pull ghcr.io/xangel82/athena-engine:1.0.0
Con Athena Logos
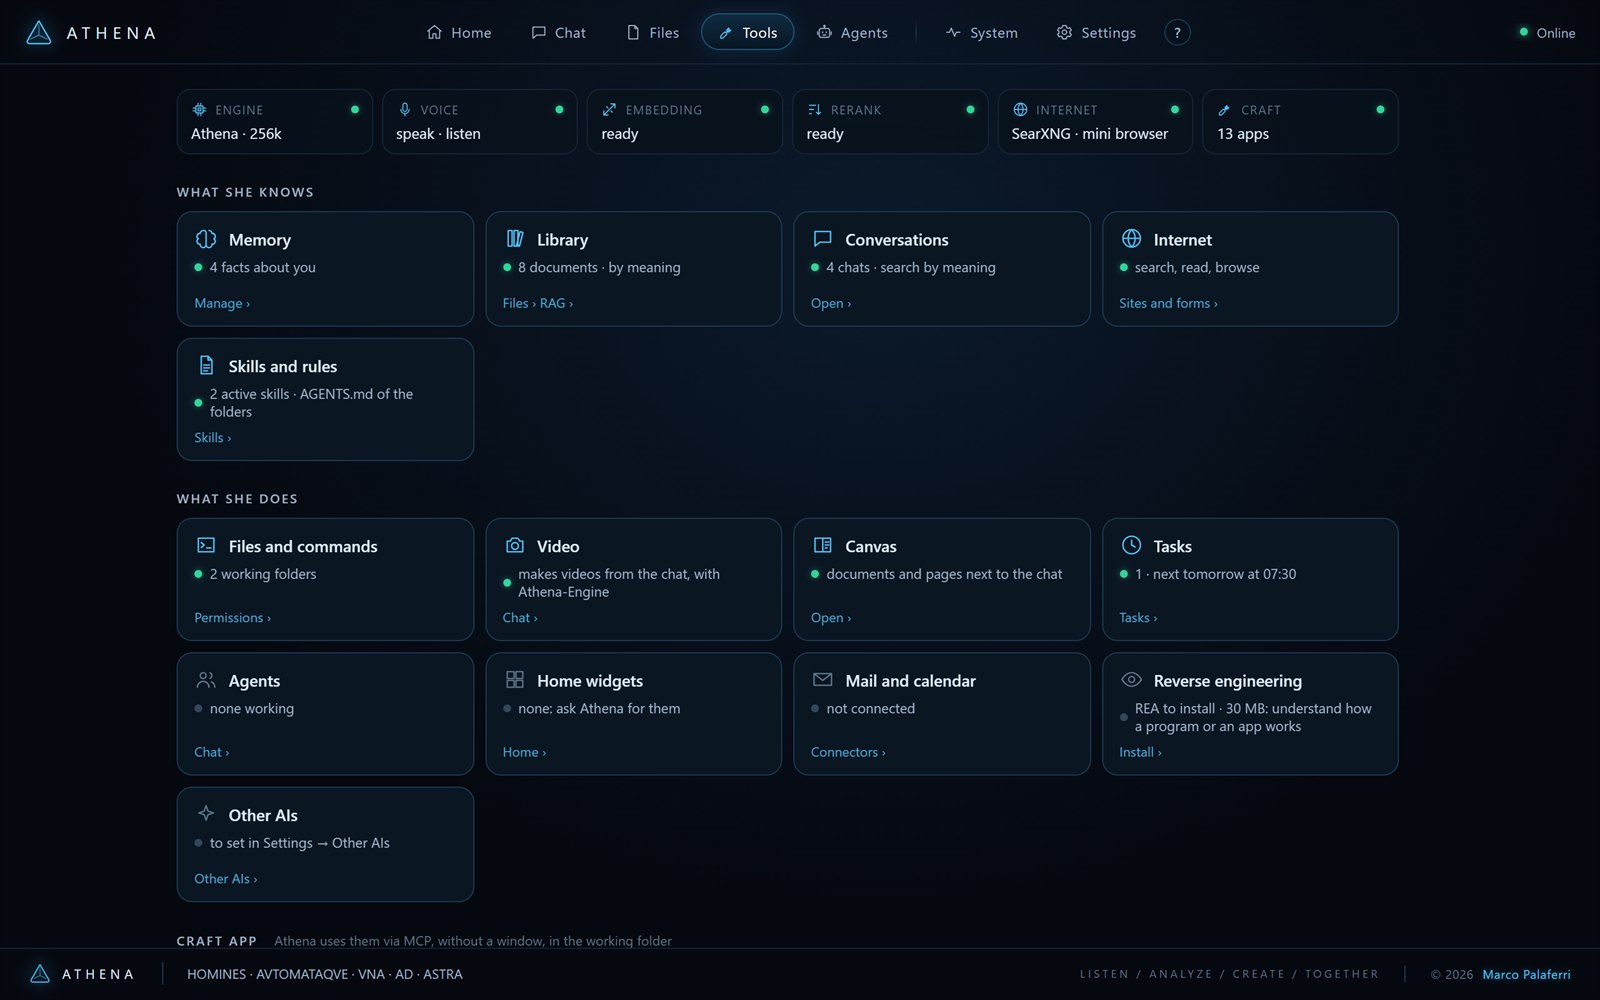
Il motore fa girare i modelli; Athena Logos è l'assistente costruito sopra. Usa la chat, la voce, la ricerca, il video e il cambio di modello della compagna di sistema.